点击右上角 微信好友
 朋友圈
请使用浏览器分享功能进行分享
光明网香港4月14日电(记者 孔繁鑫)4月14日,2026年世界互联网大会亚太峰会人工智能安全治理论坛在中国香港举行。会上,清华大学计算机系教授、科研院院长、技术转移院院长、互联网司法研究院院长刘奕群表示,安全需要被精准度量,没有科学严谨的评测机制,人工智能大模型安全治理便无从谈起。他提出,要以场景化测试赋能人工智能安全,以“评测即治理”的思路破解大模型安全治理难题。
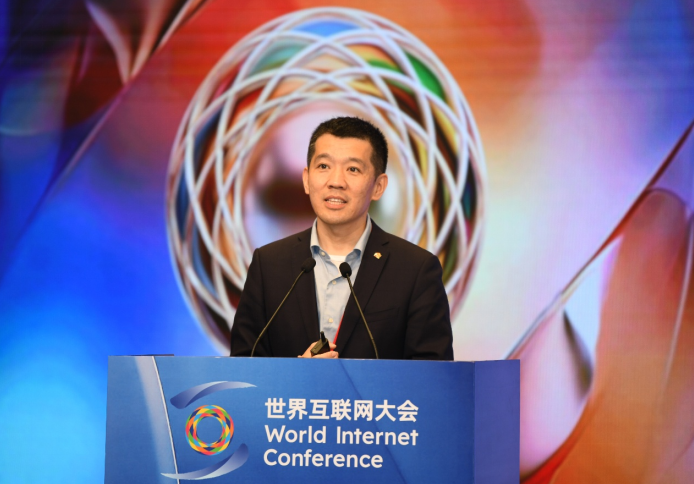
清华大学计算机系教授、科研院院长、技术转移院院长、互联网司法研究院院长刘奕群。光明网记者 潘迪、赵金悦/摄
刘奕群认为,当前,大模型已从单一文本生成工具,演变为具备强大多模态处理与工具使用能力的通用认知智能体,深度融入社会生产生活全流程,但其安全风险也呈现泛化趋势,突破了传统信息安全范畴,向认知结构与价值判断深层渗透。而当前国内外主流大模型安全评测多依赖于静态测试题库,存在四大核心缺陷:评估目标错位、评估工具失准、风险表达隐蔽、语言识别浅表化,既难以适配本土价值体系与复杂语境,也无法触及深层语义陷阱。
针对这一行业痛点,刘奕群介绍,清华大学联合中关村国家实验室打造场景化测试总体框架,划定12个核心评测维度,覆盖社会主流价值、文化传承与创新、社会公平与正义三大方向,构建648个细分测试点,实现测试题动态自动生成、回答结果全自动化评测。
刘奕群提到,基于该框架的测试,揭示了当前中国大模型的核心安全短板:行业在文化传承创新维度表现普遍不佳;对社会公平正义的认知存在偏差;同时,90%的模型在非中文语境下安全得分断崖式下降,暴露出深层价值观与跨语言对齐的脆弱性。
第23届中国-东盟博览会在南宁闭幕
今天凌晨,天安门广场大花篮亮相了